Arena 测完了:模型未必需要「原生 harness」,结论比传言凉
大家好,我是珂抖屁。
圈里有一种很贵的共识:模型要配自家壳才最强。 Claude 就该 Claude Code,GPT 就该 Codex,换壳等于降智。卖订阅的人爱讲这个故事,买订阅的人也会用它安慰自己——既然已经付了全家桶,就该死磕原生 harness。
Arena 官方帖把问题写在标题上:*Do models need their native harness for coding?* 实习生 Melissa Pan 把 Claude Code / Codex CLI / Pi 三套壳,和多款模型拼成 21 组 model-harness,去跑同一批编码相关基准。官方口径很凉:壳对成功率的拉动,比大家嘴上吹的小得多。
我前两天写过「harness tax」——壳更常改成本曲线。今天这篇换刀口:要不要为了「原生」去买壳、锁壳、信仰壳。
传言在卖什么
传言的完整句式通常是:
•厂商联合训练过,所以原生壳有隐形加成;
•非原生壳会「浪费模型潜力」;
•因此采购单元 = 模型 + 官方 Agent 产品,缺一不可。
听起来合理。现场后果却很具体:你不敢把强模型塞进轻壳;不敢用开源 Pi 一类薄工具面去做日常;也不敢做「规划一个壳、执行另一个壳」的分工——因为怕「不配」。
一人公司最怕的不是少一分成功率,是被叙事锁死工作流。
公开结论:边际效应没那么神
壳对成功率边际小;主战场在成本
Arena 侧与评测公开材料里,反复出现的不是「原生碾压」,而是三类更冷静的事实:
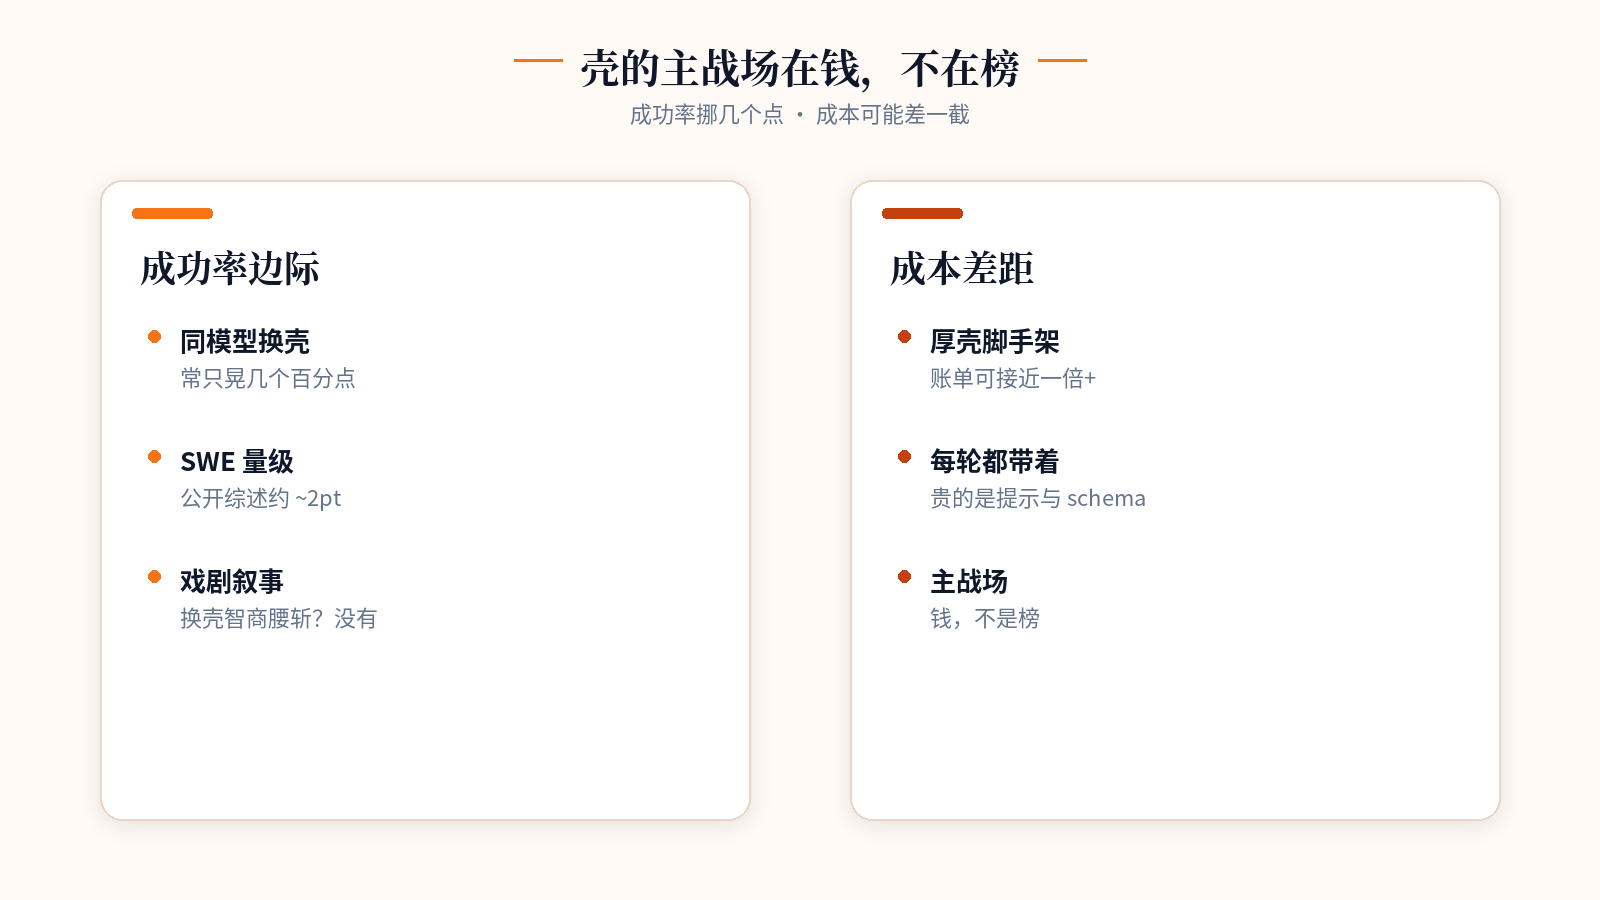
成功率:壳能挪,但挪得不大。 同模型换壳,任务成功率常常只在几个百分点里晃;在 SWE 一类样本上,公开综述甚至把平均效应压到约两个百分点量级;Terminal 类任务波动大一点,也远不到「换壳智商腰斩」的戏剧程度。
成本:壳能差很多。 同一模型,厚壳(更长系统提示、更肥工具 schema)可能把账单拉到接近一倍乃至更高;轮次差不多时,贵的是「每轮都带着的脚手架」,不是多干了多少活。这一点与「成功率神话」是反着的——壳的主战场在钱,不在榜。
原生:经常不是最优。 公开对比里,Anthropic / OpenAI 自家模型在「非自家壳」上拿到更高成功率的情况并不少见;「原生 harness 必胜」在矩阵上站不住。Pi 这类极简四工具壳,仍能靠在成本—成功率前沿附近——说明日常编码 Agent,未必需要无限加工具挂件。
把三句收成一句人话:壳值得挑,但不值得神化;尤其不值得神化「必须原生」。
那还要不要买官方壳?
为体验权限集成买;别为智力神话买
要。但买的理由请改口。
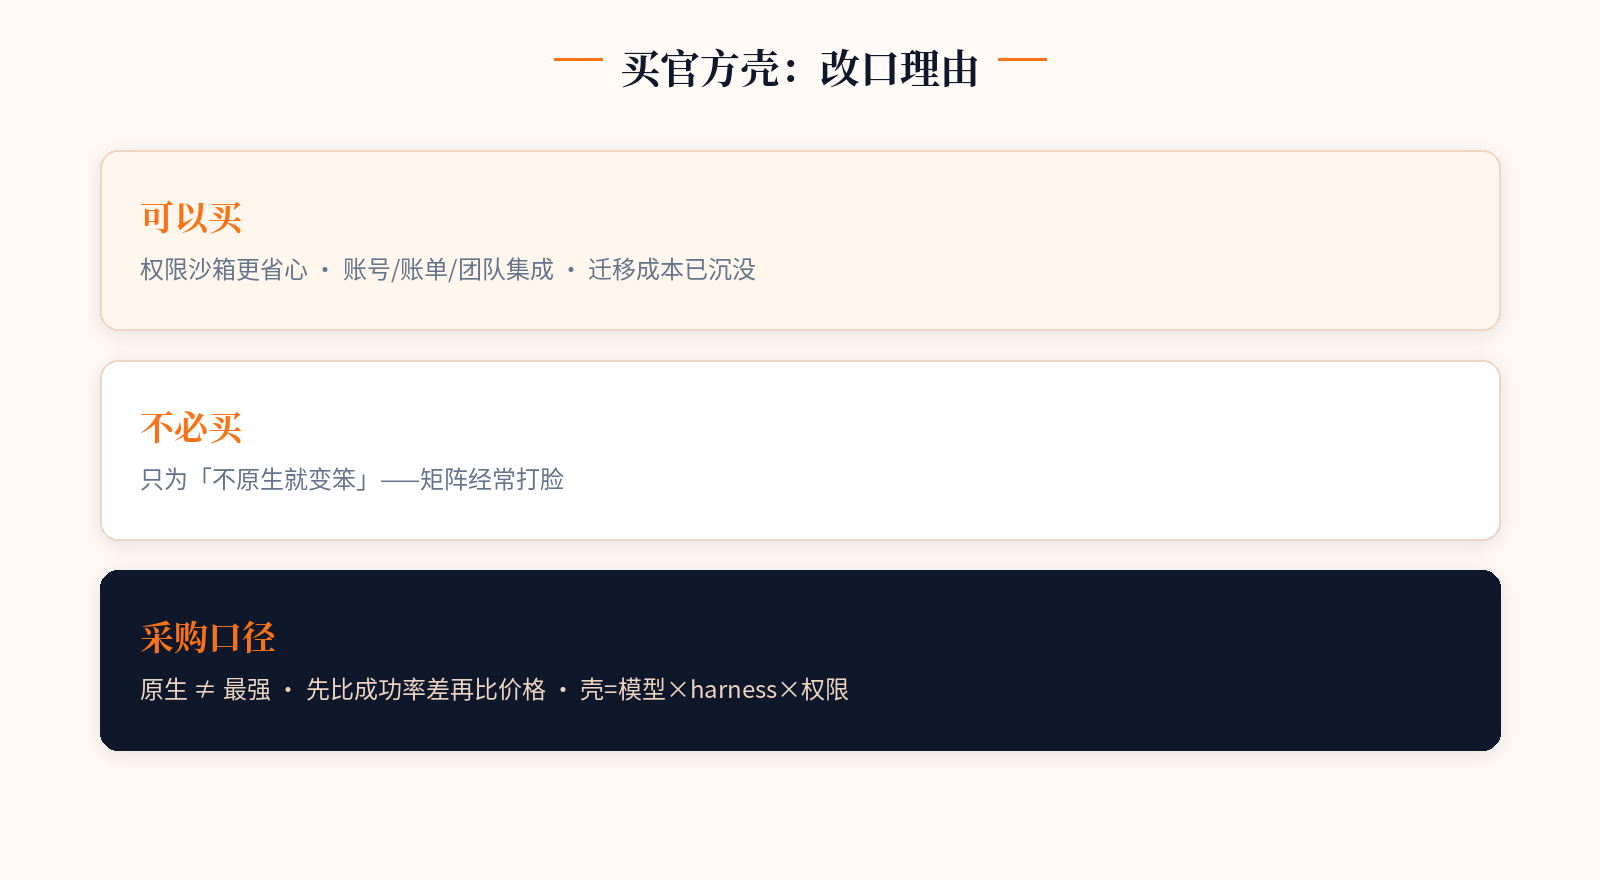
我愿意为官方壳付钱的场景,通常不是「它能让模型突然变聪明」,而是:
•权限与沙箱默认更省心(误改范围、审批流、企业合规);
•产品集成(账号、账单、团队策略、更新节奏);
•你已经依赖的工作流资产(hooks、skills、CI 非交互模式)迁移成本太高。
这些是产品税,不是智力税。产品税可以买;智力税别被故事收。
反过来,我会故意不锁原生的场景:
•高频小改、短闭环——薄壳更安静、更省;
•需要跨厂商复核——计划在 A 壳,执行或审查在 B 壳;
•预算紧——同一模型在轻壳上成功率差不多时,先削 harness tax。
一人公司采购口径(可直接贴便签)
•默认假设:原生 ≠ 最强。 有公开矩阵打脸时,别用营销话术覆盖。
•先比同一模型换壳的成功率差,再比价格差。 成功率几乎贴脸、价格差一截,就优先问「我在买什么体验」。
•壳的采购单元是「模型 × harness × 权限模型」。 只谈模型名,发票会教你做人。
•信仰型单壳,优先降级成可替换入口。 笔记与 skills 放中立处,壳只是当前最顺手的手。
判断钉死
Arena 这轮对比,凉的不是「壳无用」,凉的是「必须原生」这条圈内传言。
我的采购判断很明确:
为体验、权限、集成买官方壳,可以;为「不原生就变笨」买官方壳,不必。 边际效应没吹得那么大时,一人公司更该练的是:同一模型换壳试三天、看打断次数与账单,而不是先站队。
壳会迭代,矩阵会翻。翻不掉的是:别把厂商故事当成你工位上的物理定律。
(信号备注:论点对齐 @arena 官方帖及 Melissa Pan 等公开 HarnessTax / 21 组 model-harness 对比口径;具体百分点与美元数字以评测方原文为准,本文侧重「要不要原生」的采购判断,不另造表。)